

Golang 分布式锁实现原理
1. 分布式锁
1.1 使用场景
在分布式场景中,有时我们需要跨域多个物理节点执行加锁操作,因此我们就需要依赖到类似于 redis、mysql 这样的状态存储组件,在此基础之上实现所谓的“分布式锁”技术。
1.2 核心性质
分布式锁需要满足以下几个核心性质:
- 独占性:同一时刻只能有一个取锁方占用。
- 健壮性:锁持有者在崩溃后,锁能够被其他节点重新获取。
- 对称性:获取锁和释放锁的操作必须为同一身份,不允许非法释放他人持有的锁。
- 可用性:当提供分布式的基础组件存在少量节点发生故障时,不应该影响到分布式锁的正常使用。
1.3 实现类型
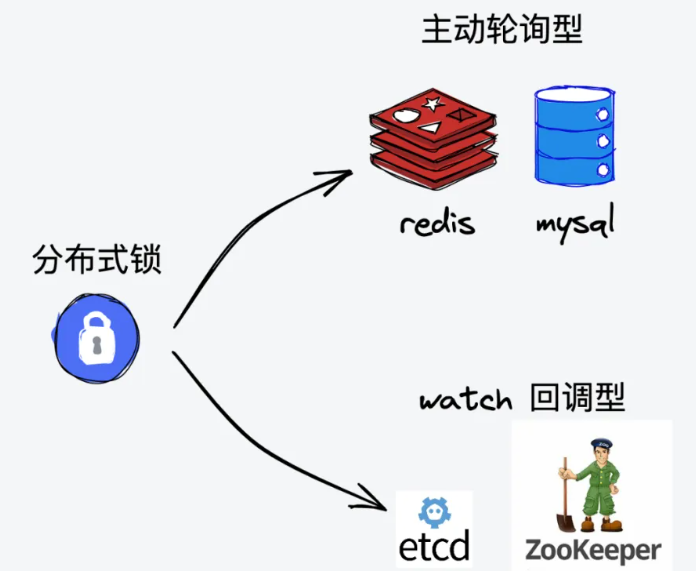
分布式锁的实现类型主要有以下几种:
- 主动轮询型:客户端通过不断地向分布式存储组件发送请求,尝试获取锁。类似于单机锁的 CAS + 自旋。
- watch回调型:客户端在获取锁失败后,会创建 watcher 监听锁的释放事件,随后不再主动获取锁;当锁被释放时,watcher 会收到通知,从而尝试重新获取锁。
2. 主动轮询型
2.1 实现思路
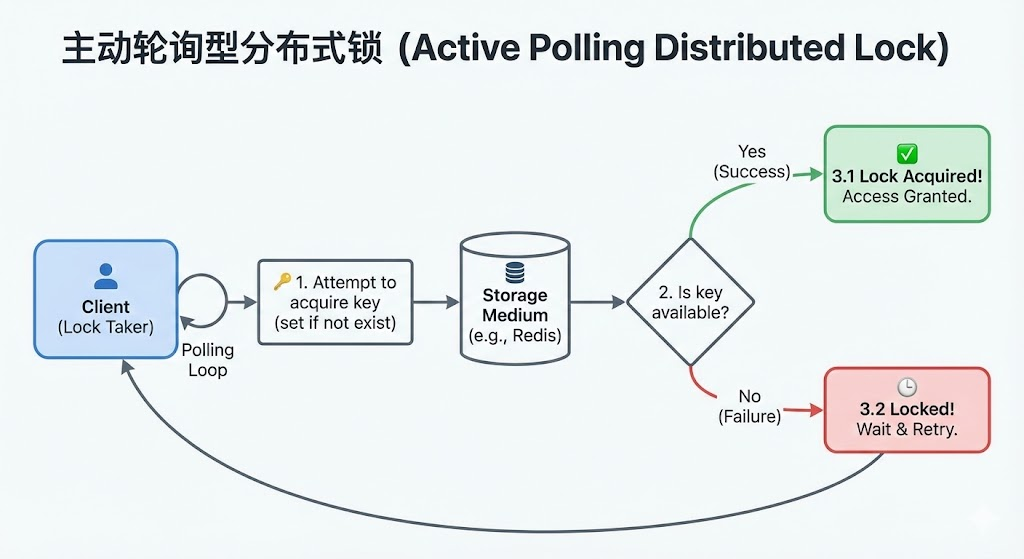
主动轮询型分布式锁的实现思路为:
- 针对于同一把分布式锁,使用同一条数据进行标识(以 redis 为例,则为同一个 key 对应的 kv 数据记录)
- 假如在存储介质成功插入了该条数据(要求之前该 key 对应的数据不存在),则被认定为加锁成功
- 把从存储介质中删除该条数据这一行为理解为释放锁操作
- 倘若在插入该条数据时,发现数据已经存在(锁已被他人持有),则持续轮询,直到数据被他人删除(他人释放锁),并由自身完成数据插入动作为止(取锁成功)
- 由于是并发场景,需要保证
- 检查数据是否已被插入
- 数据不存在则插入数据
- 这两个步骤之间是原子化不可拆分的(在 redis 中是 set only if not exist —— SETNX 操作)
2.2 技术选型
常见的分布式存储组件有 redis、mysql、zookeeper 等。
setnx 使用文档:https://redis.io/commands/setnx/ (事实上,在 redis 2.6.12 版本之后,setnx 操作已经被弃置,官方推荐大家使用 set 指令并附加 nx 参数来实现与 setnx 指令相同的效果)
此外,redis 还支持使用 lua 脚本自定义组装同一个 redis 节点下的多笔操作形成一个具备原子性的事务。
2.3 死锁问题
这项能力在 mysql 中显得捉襟见肘,不过在使用 redis 时,我们可以通过过期时间 expire time 机制得以保证。 我们通常会在插入分布式锁对应的 kv 数据时设置一个过期时间 expire time,这样即便使用方因为异常原因导致无法正常解锁,锁对应的数据项也会在达到过期时间阈值后被自动删除,实现释放分布式锁的效果。
这种过期机制的引入也带来了新的问题:因为锁的持有者并不能精确预判到自己持锁后处理业务逻辑的实际耗时,因此此处设置的过期时间只能是一个偏向于保守的经验值,假如因为一些异常情况导致占有锁的使用方在业务处理流程中的耗时超过了设置的过期时间阈值,就会导致锁被提前释放,其他取锁方可能取锁成功,最终引起数据不一致的并发问题。
针对于这个问题,在分布式锁工具 redisson 中给出了解决方案——看门狗策略(watch dog strategy):在锁的持有方未完成业务逻辑的处理时,会持续对分布式锁的过期阈值进行延期操作。
2.4 弱一致性问题
Redis 走的是 AP 架构,为了保证服务的可用性和吞吐量,Redis 在进行数据的主从同步时采用的是异步执行机制。
到这里问题就来了,试想一种场景:倘若使用方 A 在 Redis master 节点加锁成功,但是对应的 kv 记录在同步到 slave 之前,master 节点就宕机了。 此时未同步到这项数据的 slave 节点升为 master,这样分布式锁被 A 持有的“凭证” 就这样凭空消失了。 于是不知情的使用方 B C D 都可能加锁成功,于是就出现了一把锁被多方同时持有的问题,导致分布式锁最基本的独占性遭到破坏。也就是发生了一锁多持的问题。
关于这个问题,一个比较经典的解决方案是:RedLock 红锁。它采用了公式算法,同时也是 Redis 官方推荐的分布式锁实现方案,但是这种方法在发布之初就受到了不少质疑,比如时钟漂移问题、网络分区问题等。
3. redis 分布式锁
3.1 sdk 介绍
4. watch 回调型
4.1 实现思路
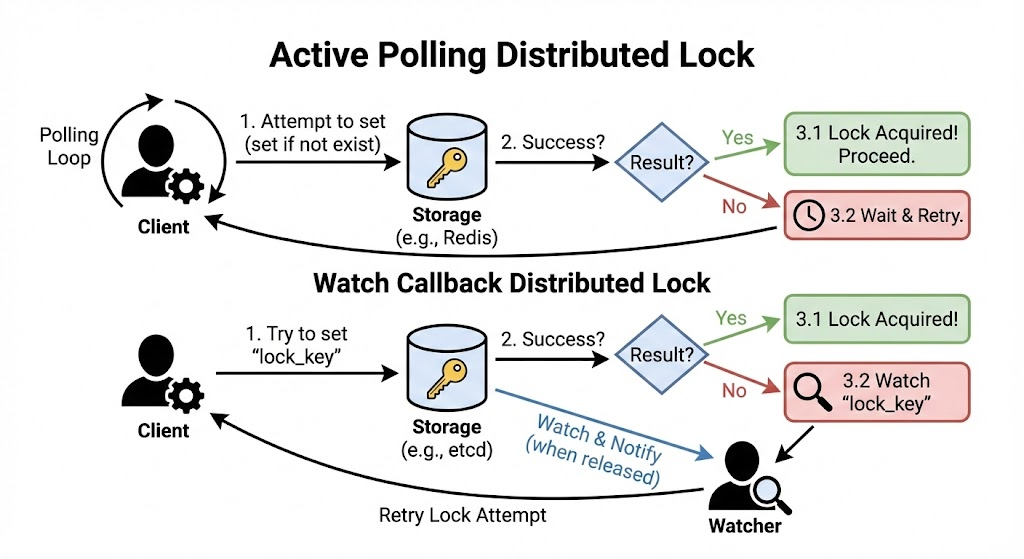
对于实现 watch 回调型分布式锁,一些基本要点和 2.1 小节中聊到的主动轮询型分布式锁类似:
- 针对于同一把分布式锁,使用一条相同的数据进行标识(唯一、明确的 key)
- 倘若在存储介质内成功插入该条数据(要求 key 对应的数据不存在),则这一行为被认定为加锁成功
- 把从存储介质中删除该条数据这行为理解为解锁操作
与主动轮询型分布式锁不同的是,在取锁失败时,watch 回调型分布式锁不会持续轮询,而是会 watch 监听锁的删除事件:
- 倘若在插入数据时,发现该条记录已经存在,说明锁已被他人持有,此时选择监听这条数据记录的删除事件,当对应事件发生时说明锁被释放了,此时才继续尝试取锁
4.2 技术选型
在实现上,我们需要依赖于提供了 watch 机制的状态存储组件,不仅能支持数据的存储和去重,还需要利用到其中的 watch 监听回调功能进行锁释放事件的订阅感知。
为满足上述诉求,我们常用的技术组件包括 etcd 和 zookeeper。
etcd 文档:https://etcd.io/
etcd 是一款适合用于共享配置和服务发现的分布式 kv 存储组件,底层基于分布式共识算法 raft 协议保证了存储服务的强一致和高可用。
在 etcd 中提供了 watch 监听器的功能,即针对于指定范围的数据,通过与 etcd 服务端节点创建 grpc 长连接的方式持续监听变更事件。
此外,etcd 中写入数据时,还支持通过版本 revision 机制进行取锁秩序的统筹协调,是一款很适合用于实现分布式锁的组件。
4.3 死锁问题
为避免死锁问题的产生,etcd 中提供了租约 lease 机制。租约,顾名思义,是一份具有时效性的协议,一旦达到租约上规定的截止时间,租约就会失去效力。 同时,etcd 中还提供了续约机制(keepAlive),用户可以通过续约操作来延迟租约的过期时间。
那么,我们如何来利用租约 lease 机制解决分布式锁中可能存在的死锁问题呢?实现思路如下:
- 用户可以先申请一份租约,设定好租约的截止时间
- 异步启动一个续约协程,负责在业务逻辑处理完成前,按照一定的时间节奏持续进行续约操作
- 在执行取锁动作,将对应于锁的 kv 数据和租约进行关联绑定,使得锁数据和租约拥有相同的过期时间属性
上面这个思路就类似于 Redis 的看门狗机制。在这样的设定之下,倘若分布式锁的持有者出现异常状况导致无法正常解锁,则可以通过租约的过期机制完成对分布式锁的释放,死锁问题因此得以规避。 此外,锁的使用方可以将租约的初始过期时间设定为一个偏小的值,并通过续约机制来对租约的生效周期进行动态延长。 可以看到,此处 etcd 中的租约及续约机制,实现了与 redisson 中 watch dog 机制类似的效果。
4.4 惊群效应
在 watch 回调型分布式锁中,惊群效应主要体现在当锁被释放时,所有监听该锁释放事件的客户端都会收到通知,从而引发一场“抢锁大战”,这可能会导致系统资源的过度消耗和性能下降。
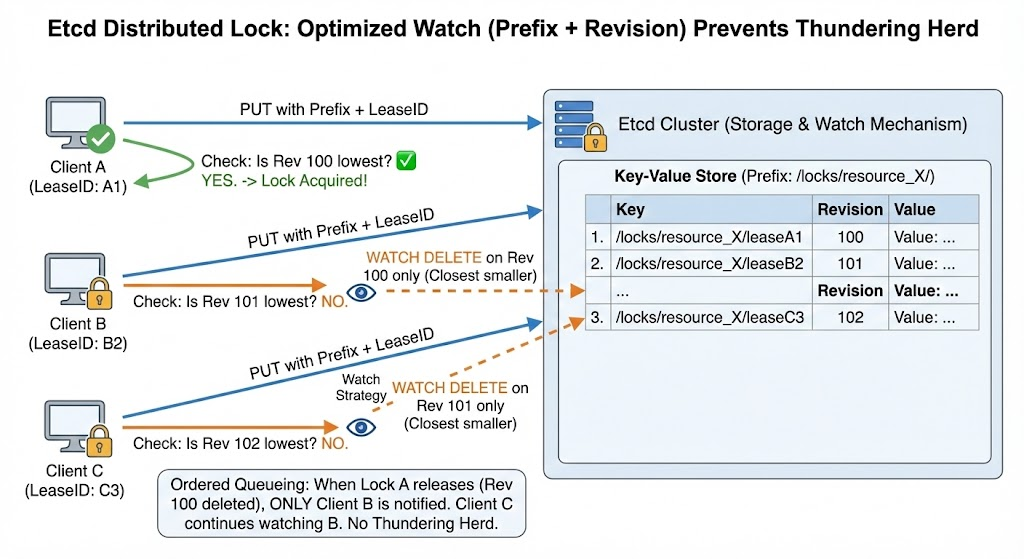
为了解决惊群效应问题,etcd 中提供了前缀 prefix 机制以及版本 revision 机制。 这和 zookeeper 中的临时顺序节点(ephemeral sequential node)有异曲同工之妙。
- 对于同一把分布式锁,锁记录数据的 key 拥有共同的前缀 prefix,作为锁的标识
- 每个取锁方取锁时,会以锁前缀 prefix 拼接上自身的身份标识(租约 id),生成完整的 lock key。 因此各取锁方完整的 lock key 都是互不相同的(只是有着相同的前缀),理论上所有取锁方都能成功把锁记录数据插入到 etcd 中
- 每个取锁方插入锁记录数据时,会获得自身 lock key 处在锁前缀 prefix 范围下唯一且递增的版本号 revision
- 取锁方插入加锁记录数据不意味着加锁成功,而是需要在插入数据后查询一次锁前缀 prefix 下的记录列表,判定自身 lock key 对应的 revision 是不是其中最小的,如果是的话,才表示加锁成功
- 如果锁被他人占用,取锁方会 watch 监听 revision 小于自己但最接近自己的那个 lock key 的删除事件。
这样所有的取锁方就会在 revision 机制的协调下,根据取锁序号(revision)的先后顺序排成一条队列,每当锁被释放,只会惊动到下一顺位的取锁方,惊群问题得以避免。
5. etcd 分布式锁
5.1 sdk 介绍
etcd 开源地址
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!