

分块莫队
分块算法
什么是分块算法
分块是一种思想,对整块整体处理,对零散快单独处理。
分块实际上就是暴力,不过可以被称为“优雅的暴力”。分块能解决很多类型的问题,很多算法也利用了分块的思想并进行优化。莫队的很多题目中也会一并使用分块来解决。
另外分块也可以分为图论分块,数论分块,字符串分块,数据结构分块等等,分块所设计的领域非常广,往往也可以使用分块来解决一些看似需要高深算法来解决的问题。
显然利用现在所学知识无法在 的时间复杂度下来解决此问题,那么这时我们可以考虑使用这种算法。
何时分块
再给出一个块,块长为,要求求解区间 的部分相关问题,如求解区间 的最大值,最小值和区间和等问题。这时我们可以来维护区间 内的块和附近的少量元素。
如何分块
块长
我们可以通过“猜”的方式来大致得出相对优秀的块长
- 长度为?长度为?如分
- 长度为 依然很难维护
- 长度为 需要维护的块 假设数据范围为 是大约个块
- 长度为 需要维护的块 只需要维护个块
实际上 块的大小可以通过计算得出
若以顺序查找来确定块,则分块查找成功时的平均查找长度为
为查找表的长度,为块的长度
为块的个数。当时,取最小值
时间复杂度
- 次询问,长度为,时间复杂度为 ,准确来说为
实现思路
我们具体需要维护的有如下三点:
- 在前面的一部分零散的元素
- 中间的若干个整块
- 后面的一部分零散的元素
具体实现
int a[N], st[N], ed[N], sum[N], add[N], len, id[N];
void change(int l, int r, int k) { if (id[l] == id[r]) { for (int i = l; i <= r; i++) { a[i] += k; sum[id[i]] += k; } } else { for (int i = l; i <= ed[l]; i++) { a[i] += k; sum[id[i]] += k; } for (int i = st[r]; i <= r; i++) { a[i] += k; sum[id[i]] += k; } for (int i = id[l] + 1; i < id[r]; i++) { add[i] += k; } }}
int query(int l, int r) { int ans = 0; if (id[l] == id[r]) { for (int i = l; i <= r; i++) { ans += a[i] + add[id[i]]; } } else { for (int i = l; i <= ed[l]; i++) { ans += a[i] + add[id[i]]; } for (int i = st[r]; i <= r; i++) { ans += a[i] + add[id[i]]; } for (int i = id[l] + 1; i < id[r]; i++) { ans += sum[i] + add[i] * (ed[i] - st[i] + 1); } } return ans;}
void solve() { int n, m; cin >> n >> m; len = sqrt(n); for (int i = 1; i <= n; i++) { cin >> a[i]; id[i] = (i - 1) / len + 1; st[i] = (id[i] - 1) * len + 1; ed[i] = min(id[i] * len, n); sum[id[i]] += a[i]; } while (m--) { int op, x, y, k; cin >> op >> x >> y; if (op == 1) { cin >> k; change(x, y, k); } else { cout << query(x, y) << endl; } }}int st[N], ed[N], mx[N], id[N], a[N], len;
int query() { int ans = 0; int l, r; cin >> l >> r; if (id[l] == id[r]) { for (int i = l; i <= r; i++) { ans = max(ans, a[i]); } } else { for (int i = l; i <= ed[id[l]]; i++) { ans = max(ans, a[i]); } for (int i = st[id[r]]; i <= r; i++) { ans = max(ans, a[i]); } for (int i = id[l] + 1; i <= id[r] - 1; i++) { ans = max(ans, mx[i]); } } return ans;}
void solve() { int n, m; cin >> n >> m; len = sqrt(n); for (int i = 1; i <= n; i++) { cin >> a[i]; id[i] = (i - 1) / len + 1; st[id[i]] = (id[i] - 1) * len + 1; ed[id[i]] = id[i] * len; mx[id[i]] = (i == st[id[i]]) ? a[i] : max(mx[id[i]], a[i]); } while (m--) { cout << query() << endl; }}莫队算法
莫队?
何为莫队算法
为了解决区间问题,最开始的区间问题是前缀和,然后出现越来越难的问题,越来越困难的算法:分块,RMQ,树状数组,线段树等等,于是莫队算法出现,就是为了解决这类的区间问题。
分块算法和莫队算法的异同
同:
- 都是为了解决区间问题而存在
异:
- 莫队查询的更快 但是只能离线查询
- 分块查询的更慢 但是可以在线查询
离线查询:查询操作是在已知所有查询的情况下进行的。也就是说,在开始查询之前,所有的查询都已经确定并且可以提前处理。
在线查询:查询操作是在不知道所有查询内容的情况下进行的。每次查询时都立即处理,不会提前对查询进行任何优化。查询顺序通常是动态的。
莫队算法基本原理
利用双指针来进行区间的移动查询
莫队算法的核心
while (l > q[i].l) { add(a[--l]);}while (r < q[i].r) { add(a[++r]);}while (l < q[i].l) { del(a[l++]);}while (r > q[i].r) { del(a[r--]);}具体实现
int a[N], sum, ans1[N], len, ans2[N], cnt[N];
struct query { int l, r, id;} q[N];
void add(int x) { sum += cnt[x]; cnt[x]++;}
void del(int x) { cnt[x]--; sum -= cnt[x];}
void solve() { int n, m; cin >> n >> m; len = sqrt(n); for (int i = 1; i <= n; i++) { cin >> a[i]; } for (int i = 1; i <= m; i++) { cin >> q[i].l >> q[i].r; q[i].id = i; } sort(q + 1, q + m + 1, [](const query &lhs, const query &rhs) { if ((lhs.l - 1) / len != (rhs.l - 1) / len) return lhs.l < rhs.l; return lhs.r < rhs.r; });
for (int i = 1, l = 1, r = 0; i <= m; i++) { if (q[i].l == q[i].r) { ans1[q[i].id] = 0; ans2[q[i].id] = 1; continue; } while (l > q[i].l) { add(a[--l]); } while (r < q[i].r) { add(a[++r]); } while (l < q[i].l) { del(a[l++]); } while (r > q[i].r) { del(a[r--]); } if (sum == 0) { ans1[q[i].id] = 0; ans2[q[i].id] = 1; continue; } ans1[q[i].id] = sum; ans2[q[i].id] = (r - l + 1) * (r - l) / 2; int t = __gcd(ans1[q[i].id], ans2[q[i].id]); ans1[q[i].id] /= t; ans2[q[i].id] /= t; } for (int i = 1; i <= m; i++) { cout << ans1[i] << '/' << ans2[i] << endl; }}普通莫队的优化
奇偶排序优化
对于如下数据:
设块的大小为21 12 1003 14 100经过排序后的等效数据:
1 12 1003 14 100手动模拟一下可以发现, 指针的移动次数大概为次,我们处理完第一个块之后,此时只需要移动2次指针到就可以得到第四个询问的答案,再移动次到就可以得到第三次询问的答案,但是我们却将指针移动次到来获取第三个询问的答案,再移动次到获取第四个询问的答案,这样多了次的指针移动。我们怎么优化这个地方呢?
这里我们就要用到奇偶化排序。什么是奇偶化排序?奇偶化排序即对于属于奇数块的询问,按从小到大排序,对于属于偶数块的排序,从大到小排序,这样我们的指针在处理完这个奇数块的问题后,将在返回的途中处理偶数块的问题,再向移动处理下一个奇数块的问题,优化了指针的移动次数,理论上能快一倍。
优化后并排序后的等效数据:
1 12 1004 1003 1 sort(q + 1, q + m + 1, [](const query &lhs, const query &rhs) { if ((lhs.l - 1) / len != (rhs.l - 1) / len) { return lhs.l < rhs.l; } if (((lhs.l - 1) / len + 1) & 1) { return lhs.r < rhs.r; } return lhs.r > rhs.r; });bool cmp(node a,node b) { return pos[a.l] ^ pos[b.l] ? pos[a.l] < pos[b.l] : pos[a.l] & 1 ? a.r < b.r : a.r > b.r;}块的大小优化
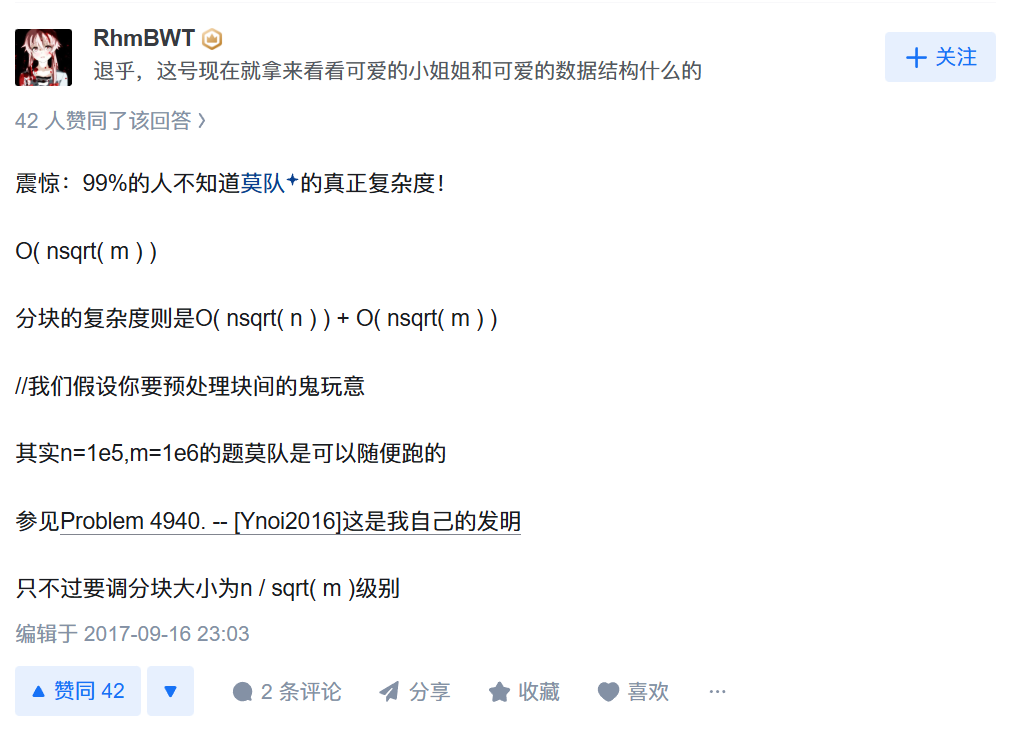
网上大多都说分块大小取最优,此时时间复杂度为,实际上这是不严谨的,当,差距较大时使用作为分块大小效率会明显降低。
普通莫队时间复杂度的证明:
具体证明方法有多种:
- 第一种(By yihang_01)
记:令每一块中 的最大值为 。
由第一次排序可知,
。
显然,对于每一块暴力求出第一个询问的时间复杂度为 。
考虑最坏的情况,在每一块中, 的最大值均为 ,每次修改操作均要将 由 修改至 或由 修改至 。
考虚 :因为 在块中已经排好序,所以在同一块修改它的时间复杂度为 。
对于所有块就是 。
重点分析 :因为每一次改变的时间复杂度都是 的,所以在同一块中的时间复杂度为
将每一块上的时间复杂度合在一起,可以得到
由于 最大为 ,所以 的总体时间复杂度最坏为 。
综上所述,莫队算法的时间复杂度为 。
- 第二种
-
排序:
-
设每个块 中分布有 个左端点,那么处理块 的最坏时间复杂度为 。 指针跨越整个块的时间复杂度是 ,要跨越 次,所以左端点移动的总时间复杂度为 。
-
右端点在一个左端点相同的块内是有序的。对于每个块 中的 个区间,右端点最多跳完整的一个序列(不会往回跳)。一共有 个块,所以右端点移动的总时间复杂度为 。
总复杂度:
- 第三种
分块相同时,右端点递增是的,分块共有个,复杂度为
分块转移时,右端点最多变化,分块共有个,复杂度为
分块相同时,左端点最多变化,分块转移时,左端点最多变化
共有个询问,复杂度为
综上,次询问,长度为,块大小为的莫队,时间复杂度为。
普通莫队最优块长的证明:
设每一块的大小为,序列长为,询问个数为。
那么最多有块。
对于右端点的移动,每一块最多移动次,有块,所以右端点时间复杂度为。
对于左端点的移动,每一次最多移动次,有次移动,所以左端点时间复杂度为。
那么总时间复杂度为。
设。
原式等于。
这样变为一个经典的二次函数求最小值的问题。
为取到最小值,。
那么。
代入回
算出
其他莫队
带修莫队
前面说过,普通莫队只能解决没有修改的问题,那么如果想解决修改问题呢?
那就需要带修莫队,带修莫队就是一种支持修改查询的莫队。
当然,这是一道在线问题,但我们可以把这个在线问题转化为离线问题。
普通莫队是把点经过排序,下一次询问是从上一次询问转移而来,但是有修改的问题在经过排序后,查询的结果也会随着排序而改变,把所有的修改操作加上一个时间戳 。
排序规则:第一关键字为左端点所在块 ,第二关键字为右端点所在块 ,第三关键字是时间 。
每次询问先做区间拓展,再考虑时间戳,也就是之前的修改对当次查询的影响。
(1) > ,则把 到 个修改的贡献加上
(2) < ,则把 到 个修改的贡献还原
带修莫队的时间复杂度及最优块长的证明
块的大小为 ,修改个数为 ,询问次数为 ,则总移动次数为 ,操作次数为 的话,则为 。
可以取
正常写题时肯定不会去算这么离谱的一个块长 ,直接视作 的话,就可以得到总移动次数为 ,那么当 时,取得最小值,此时最小值为 。
同样,对于最优块长也可以做如下证明:
可以这么认为,序列的值是随着时间而变化的。
那我们就在坐标系上再加上一个时间维度,用 来表示一个查询
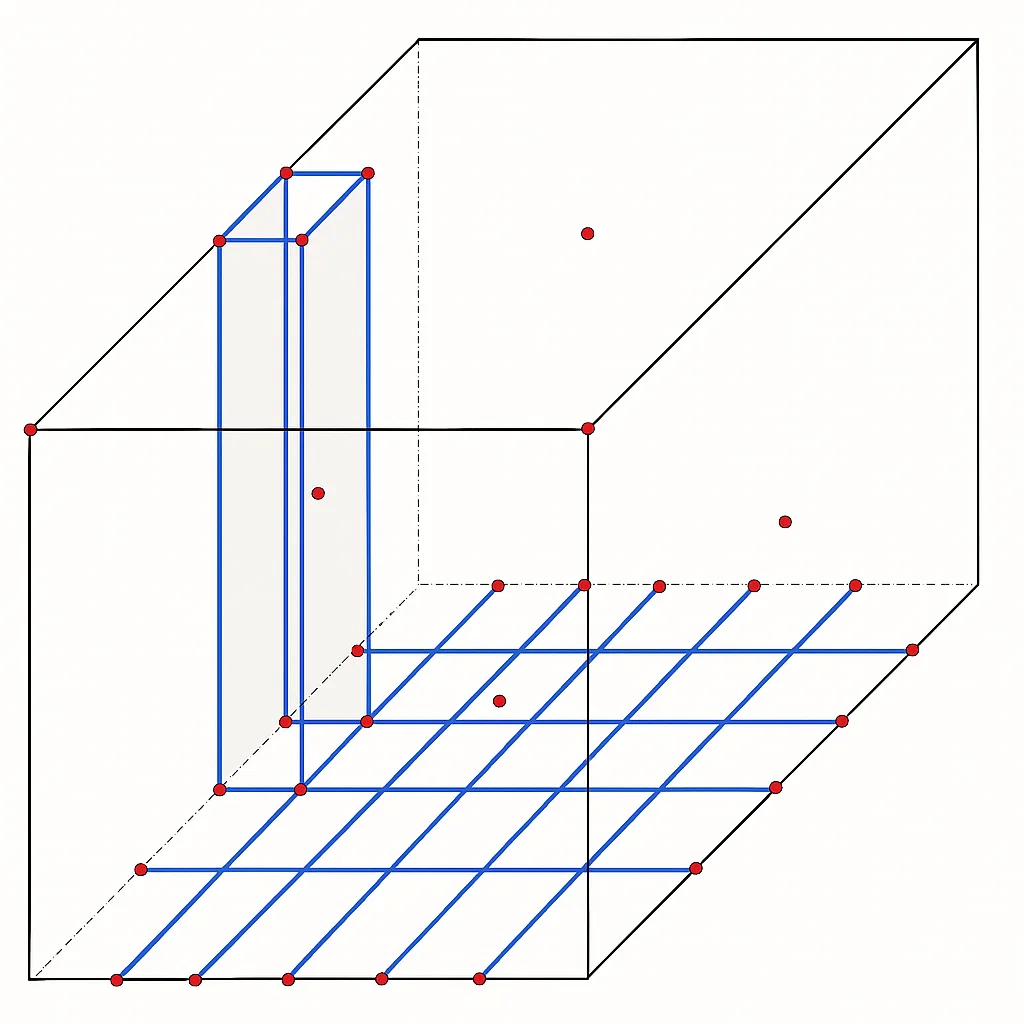
很明显,我们需要分别按照l与r分块,在同一块内的询问按照t从小到大完成。块的大小就是 ,只是这个粗略得出的块长只是相对优秀的,而不是最优。
综上,带修莫队的渐进时间复杂度为 (视作 ),认为是 。
实现过程
对于询问,我们记录以下值:
struct kkk { int l; //左端点 int r; //右端点 int t; //此询问前修改数量 int id; //询问编号}q[N];对于修改,我们记录以下值:
struct ttt { int id; //修改位置 int val;//修改值}c[N];将原来值对答案的影响抹去,再将修改值对答案的影响加上,然后更新该位置的值
#define add(x) { if(++vis[x]==1)sum++;}#define del(x) { if(--vis[x]==0)sum--;}void change(int x) { if(c[x].id>=l&&c[x].id<=r) { del(v[c[x].id]); add(c[x].val); } //改变影响 swap(c[x].val,v[c[x].id]); //值更新 *}...while(now<q[i].t)change(++now); //修改while(now>q[i].t)change(now--); //修改这道题能转化为离线的根本原因是这一次的查询并不需要使用上一次的查询结果,只是题目让我们立即返回查询结果,但当次结果只是依赖于之前的修改,而不是依赖于之前的查询,所以我们给修改打上一个时间戳就可以了。
int n, m;int len;int mq, mr;struct op { int l, r; int idx, tim; bool operator<(const op& that) const { if (l / len != that.l / len) return l < that.l; if (r / len != that.r / len) return r < that.r; return tim < that.tim; }} q[N];struct modify { int p, c;} R[N];int a[N], cnt[N];int ans[N];int res;void add(int x) { if (cnt[x] == 0) res++; cnt[x]++;}void del(int x) { cnt[x]--; if (cnt[x] == 0) res--;}void solve() { cin >> n >> m; len = pow(n, 2.0 / 3.0); int l, r; char ch; for (int i = 1; i <= n; i++) { cin >> a[i]; } for (int i = 1; i <= m; i++) { cin >> ch >> l >> r; if (ch == 'Q') q[++mq] = {l, r, mq, mr}; else R[++mr] = {l, r}; } sort(q + 1, q + 1 + mq); for (int i = 1, l = 1, r = 0, x = 0; i <= mq; i++) { while (q[i].l < l) add(a[--l]); while (r < q[i].r) add(a[++r]); while (l < q[i].l) del(a[l++]); while (q[i].r < r) del(a[r--]);
// 时间戳 // 要将 a[pos] 和 R[x].c 交换,而不能用其他变量代替,因为需要来回滚动 while (x < q[i].tim) { ++x; // 先加 int pos = R[x].p; // 修改数在区间内 if (l <= pos && pos <= r) { add(R[x].c); del(a[pos]); } swap(a[pos], R[x].c); } while (x > q[i].tim) { int pos = R[x].p; if (l <= pos && pos <= r) { add(R[x].c); del(a[pos]); } swap(a[pos], R[x].c); x--; // 后减 } ans[q[i].idx] = res; }
for (int i = 1; i <= mq; i++) { cout << ans[i] << endl; }}回滚莫队
当删除或增加的其中一个在操作时,不能或者不方便统计答案时,可以尝试使用回滚莫队解决。
原题链接
zh-CN链接
实现过程
- 对于左右端点在同一块的暴力计算。
- 跟普通莫队一样排序,左端点换块时清空答案,把左指针设为左端点所在块的下一块的开头,把右指针设为左端点所在块的最后一位。这样右指针是单调递增的,每处理一个询问时,先记录一些信息(比如答案),再左移左指针并更新答案,然后把左指针移回左端点所在块的下一块的开头,过程中回滚除记录下的信息以外的其它影响,最后把记录下的信息恢复。如:先右移右指针,再记录 ,然后左移左指针时增加 并更新 ,回滚时把增加的 减掉,最后把 回滚为记录的值。
{% folding 查看代码 By yihang_01 %}
int n, m, a[N], len, cnt1[N], cnt2[N], ans[N], st[N], ed[N], id[N], b[N], p;//cnt1 为统计数字个数的桶,cnt2 为处理暴力结果的桶,ans 为答案数组,b 为离散化后的数组,p 为离散化后的数组长度
struct query { int l, r, id; bool operator<(const query &rhs) const { if (::id[l] != ::id[rhs.l]) return l < rhs.l; return r < rhs.r; }} q[N];
void add(int x, int &tmp) { ++cnt1[x]; tmp = max(tmp, cnt1[x] * b[x]);}
void del(int x) { --cnt1[x]; }
void solve() { cin >> n >> m; len = sqrt(n); for (int i = 1; i <= n; i++) { cin >> a[i]; b[i] = a[i]; id[i] = (i - 1) / len + 1; st[i] = (id[i] - 1) * len + 1; ed[i] = min(id[i] * len, n); } for (int i = 1; i <= m; i++) { cin >> q[i].l >> q[i].r; q[i].id = i; } sort(q + 1, q + m + 1);
// 离散化 sort(b + 1, b + n + 1); p = unique(b + 1, b + n + 1) - b - 1; for (int i = 1; i <= n; i++) a[i] = lower_bound(b + 1, b + p + 1, a[i]) - b;//a 数组现在存放的是离散化后的值 int now = 0, last = 0, lstl = 0, tmp = 0; for (int i = 1, l = 1, r = 0; i <= m; i++) { if (id[q[i].l] == id[q[i].r]) { // 左右区间属于同一块则进行暴力处理答案 for (int j = q[i].l; j <= q[i].r; j++) ++cnt2[a[j]]; for (int j = q[i].l; j <= q[i].r; j++) ans[q[i].id] = max(ans[q[i].id], cnt2[a[j]] * b[a[j]]); for (int j = q[i].l; j <= q[i].r; j++) --cnt2[a[j]]; continue; } // 访问到了新的块,先把上一个块的答案清空 if (id[q[i].l] != last) { while (r > ed[q[i].l]) del(a[r--]); // 右指针移至上一个区间的右端点 while (l <= ed[q[i].l]) del(a[l++]); // 左指针右移至下一个区间的左端点 tmp = 0; last = id[q[i].l]; } // 扩展右指针 while (r < q[i].r) add(a[++r], tmp); lstl = l; // 准确来说 l 才是原先的左指针 now = tmp; // 非常重要 // 扩展左指针 while (lstl > q[i].l) add(a[--lstl], now); ans[q[i].id] = now; // 回滚左指针 while (lstl < l) del(a[lstl++]); } for (int i = 1; i <= m; i++) cout << ans[i] << '\n';}树上莫队
莫队算法的出现正是为了解决部分数据结构相关问题而存在,当然可以上树。
P2325 [SCOI2005] 王室联邦这道题目可以说是专为树上莫队设计的题目。
分块方式
这里提供一种构造方式,证明略。
dfs,并创建一个栈,dfs一个点时先记录初始栈顶高度,每dfs完当前节点的一棵子树就判断栈内(相对于刚开始dfs时)新增节点的数量是否≥B,是则将栈内所有新增点分为同一块,核心点为当前dfs的点,当前节点结束dfs时将当前节点入栈,整个dfs结束后将栈内所有剩余节点归入已经分好的最后一个块。
void solve() { auto dfs = [&](auto &&self, auto u, auto fa) -> auto { int t = top; for (int i = head[u]; i; i = nxt[i]) { int v = to[i]; if (v != fa) { dfs(v, u); if (top - t >= B) { key[++tot] = u; while (top > t) bl[stk[top--]] = tot; } } } stk[++top] = u; }; dfs(1, 0); if (!tot) ++tot; key[tot] = 1; while (top) bl[stk[top--]] = tot;}lambda函数原本是不支持递归的,但是有几种方法使其支持递归:
-
传入参数 auto &&self 如
auto dfs = [&](auto &&self, auto u, auto fa) -> auto递归时使用self递归 -
采用匿名函数 如
function<void(int,int)> dfs = [&](auto u,auto fa) -> auto递归时使用原函数名递归 -
采用Deducing this特性 如
auto dfs = [&] self(auto u, auto fa) -> auto递归时使用self名递归
为什么lambda自身在定义时无法被调用
-
匿名性:Lambda 表达式是匿名的,编译器在定义时不为其生成名称,因此无法在其内部直接引用或调用自己。
-
捕获和名称:在 lambda 定义时,虽然可以捕获外部变量,但不能直接引用自身,因为 lambda 的名字在定义时尚未确定。
auto dfs = … 的写法只是将一个 Lambda 表达式赋值给名为dfs的变量,并没有定义一个真正的命名函数。它本质上是一个匿名函数,只是通过auto dfs来保存该变量,而非声明了一个具名函数。
修改方式
所谓“修改”,就是由询问 更新至询问 。
如果把两条路径上的点全部修改,复杂度是和暴力一样的,所以需要做一些处理。
表示 到 的路径上除 外的所有点构成的集合, 代表 到的路径,表示集合对称差(就跟异或差不多)。
- 两个指针 (相当于序列队的 两个指针), 记录 的答案, 数组记录每个节点是否在 内。
- 由 更新至 时,将 和 的 分别取反,并相应地更新答案。
- 将答案记录到 数组(离线后用于输出那个)时对 (此时的 已更新为上一步中的 )的 取反并更新答案,记录完再改回来(因为 处理比较麻烦,这样搞比较方便)。
之所以要把 转化成 ,是因为这样的话就能通过对询问排序来保证复杂度。排序方式就是以所在块编号为第一关键字, 的编号为第二关键字排序。如果结合了带修莫队,就还要以时间为第三关键字。
时间复杂度
不带修:,带修:
莫队的在线化改造
上面这道题做如下修改:
- 在读入每个更新操作的位置 时,把 用上一次 的答案进行异或后再得到真正的 。
有了这个背景,就能更清楚的理解为什么原题可以改造为离线了,而这道修改后的题目不可以。正因为每次修改操作紧密联系于上一次查询操作,必须真的按照题目的要求“立即输出查询结果”才能进行此次修改,而原题可以假的“立即输出”。如果把这道题强行加上时间戳,如果经过排序后第 个修改操作是原来的第 个修改,那此次操作需要用到第 行的查询结果(假设输入为一行修改+一行查询),而想要得到 行的查询结果,有需要用到 行的修改,反复套娃,这个排序不如不排,时间复杂度直接变为 。
所以这下真的变成在线了,不能用莫队了。
但我相信大家是不会使用Spaly/Fenwick/Segt(可能是主席树)来做这道题的(以上均为口胡,没写过)。
不,这道题还可以使用莫队,我们可以强行来用莫队,进行莫队的在线化改造!
普通莫队的在线化改造
在线化改造的关键
我们都知道,普通的莫队算法会先把所有查询离线排好序,然后通过“从上一个查询区间转移到下一个区间”的方式来快速计算答案。
但如果我们想把莫队算法“在线化”,就不能简单地从上一个查询区间直接转移。为应对这种情况,可以先挑选出一些特别的区间作为“特征区间”,并处理这些特征区间的答案,让这些区间成为莫队中的“上一个区间”,在线查询就能从相应的特征区间“跳转”过来。
特征区间的要求
- 这些特征区间的所有信息,必须能在可接受的时间复杂度内全部算出来。
- 对于任意一个真实查询,都能在合适的时间内从某个特征区间转移过来。
选取特征点
假设我们在序列中每隔 步选一个“特征点”,并且把任意两个特征点之间的区间都做成特征区间。
- 这样,预处理时的复杂度大约是 。
- 当处理一个真实查询时,如果只要移动区间的左右端点分别不超过 步,那么就能从相应的特征区间转移到真实查询的区间,花费 的时间。
- 可以证明 最优。
保存特征区间信息
为了在后来能够复用特征区间的信息,需要记录下:
- 特征区间的答案本身。
- 莫队所需的辅助信息,比如每种颜色在区间内出现的次数等(常见于莫队中统计出现频次的需求),往往是几个数组。
直接记住所有特征区间的完整信息可能会占用过多的空间导致爆空间。绝大多数莫队所需要的数据都具有“可减”性质(例如出现次数可以通过增减来实现维护),所以我们只需要把 这前缀范围的信息保存起来,需要时再用前缀和或加减方法获得目标区间的数据。
实现步骤
- 先对所有特征区间做预处理,存下它们的答案和辅助信息。
- 当真正查询出现时,先找到“最近”的特征区间,再通过不超过 步的端点移动,将这个特征区间调整到查询所需的区间,并得出结果。
这样一来,就能把原本只能离线处理的莫队,做成一个“在线化”的版本,成功实现了莫队的在线化改造。
带修莫队的在线化改造
普通莫队的改造中提到的特征区间预处理只是个常见的小技巧,但需要在预处理阶段对所有特征区间的答案和信息进行保存,这让我们在支持修改时很麻烦。
回顾带修莫队做法:在每次查询前,先把修改操作处理到当前时间,维护相关结构后再进行查询。此时常见的数据结构(如线段树)通常是“懒标记”地处理修改,只有在真正需要的时候才更新。
本算法则类似:
- 我们仍然划分特征区间,并在预处理时保存中间信息,但在执行修改时不直接更新特征区间的答案,仅更新莫队维护的核心信息(如颜色出现次数等)即可。
- 询问发生时,如果特征区间的答案早就过期(上次更新时间小于当前时间),就先更新它,再从这个特征区间转移到目标区间并得到正确答案。
- 由于莫队在维护中间信息时是最新的,所以真正计算答案时要“反向”更新,以保证最终求得的是当前正确结果。
时间复杂度分析
- 若 ,则选取的特征点有 个。
- 每次修改若强行更新所有预处理区间会导致极高复杂度,所以采用“懒更新”方式,仅在需要时才刷新对应区间的答案。
- 总整体复杂度约为 ,与带修莫队相当,但原则上不会达到最坏情况。
实现步骤简要
- 预处理:计算并存下所有特征区间的答案 + 中间信息
- 修改:只更新莫队中间状态,不更新特征区间答案
- 查询:
- 若特征区间答案过期,先更新
- 再用不超过 次移动,将特征区间扩展/收缩到查询区间,输出结果
时空复杂度的分析
在普通莫队基础上做在线化改造,时间复杂度保持不变,但会额外消耗 的空间;在带修莫队基础上做改造,时间复杂度也与带修莫队相同,但需要额外 的空间。尽管改造过程只需“向前修改”,常数因素仍会导致实际运行效率与原带修莫队相差不大。
#include <bits/stdc++.h>using namespace std;const int MAXN = 50050;const int BLNB = 550;const int COL = 1000050;void read(int &x) { char ch; while (ch = getchar(), ch < '!'); x = ch - 48; while (ch = getchar(), ch > '!') x = (x << 3) + (x << 1) + ch - 48;}int target[MAXN];struct Change { int p, col, las;} change[MAXN];int nc, n, m, mp[COL], tot, D, cnt[BLNB][MAXN * 2], c[MAXN], blnm, spe[BLNB];int CNT[MAXN * 2], ans[BLNB][BLNB], ima, tim[BLNB][BLNB], id[MAXN];// 细节:我们不能直接在cnt[][]上做更改,所以需要记录一个临时的变化量数组CNT[]// 变量解释:nc表示当前时间,mp[]和tot是离散化用的,D表示特征点步长,cnt[][]是预处理的莫队信息,id[]记录下标为i的特征点是第几个特征点,spe[]用于存储所有的特征点下标,ans[][]表示特征区间的答案,tim[][]记录答案的上一次更新时间,target[]表示离位置i最近的特征点坐标。inline int getc(int sl, int sr, int p) { if (sl == 0 && sr == 0) return 0; else { if (c[sl] == p) return cnt[id[sr]][p] - cnt[id[sl]][p] + 1; else return cnt[id[sr]][p] - cnt[id[sl]][p]; } // 细节:端点特判一下}// 函数作用:读取区间[sl,sr]中的莫队数组信息。inline void del(int pos, int sl, int sr) { if ((--CNT[c[pos]]) + getc(sl, sr, c[pos]) == 0) --ima;}inline void add(int pos, int sl, int sr) { if ((++CNT[c[pos]]) + getc(sl, sr, c[pos]) == 1) ++ima;}int main() { read(n); read(m); D = pow(n, 2.0 / 3); // 带修莫队的块大小 for (int i = 1; i <= n; ++i) { read(c[i]); if (!mp[c[i]]) c[i] = mp[c[i]] = ++tot; else c[i] = mp[c[i]]; } int tmp = 1; spe[blnm = 1] = 1; id[1] = 1; for (int i = 1; i <= n; ++i) { if (i - tmp == D) tmp = i, spe[++blnm] = i, id[i] = blnm; target[i] = tmp; } // 预处理特征点以及每个点对应的离它最近的特征点 int p = 1; for (int i = 1; i <= n; ++i) { ++CNT[c[i]]; if (i == spe[p]) { for (int j = 1; j <= n; ++j) cnt[p][j] = CNT[j]; ++p; } } // 预处理莫队所需信息 for (int i = 1; i <= blnm; ++i) { int p = i + 1; ima = 0; memset(CNT, 0, sizeof CNT); for (int j = spe[i]; j <= n; ++j) { if ((++CNT[c[j]]) == 1) ++ima; if (j == spe[p]) { ans[i][p] = ima; ++p; } } } // 预处理特征区间答案 memset(CNT, 0, sizeof CNT); while (m--) { char opt; int l, r; ima = 0; while (opt = getchar(), opt != 'Q' && opt != 'R'); read(l); read(r); if (opt == 'R') { change[++nc].p = l; if (!mp[r]) r = mp[r] = ++tot; else r = mp[r]; change[nc].col = r; change[nc].las = c[l]; int p = blnm; for (; spe[p] >= l; --p) --cnt[p][c[l]], ++cnt[p][r]; // 修改中间过程的信息 c[l] = r; } else { int sl = target[l], sr = target[r]; int SL = sl, SR = sr; // sl、sr表示所需特征区间的左右端点。 if (sl == sr) { for (int i = l; i <= r; ++i) if (++CNT[c[i]] == 1) ++ima; printf("%d\n", ima); // 细节:区间左右端点所属特征点相同,暴力计算 for (int i = l; i <= r; ++i) --CNT[c[i]]; // 临时数组还原 } else { for (int t = nc; t > tim[id[sl]][id[sr]]; --t) { if (sl <= change[t].p && change[t].p <= sr) { if (++CNT[change[t].las] + getc(sl, sr, change[t].las) == 1) --ans[id[sl]][id[sr]]; if (--CNT[change[t].col] + getc(sl, sr, change[t].col) == 0) ++ans[id[sl]][id[sr]]; // 反向计算答案,即把原来带修莫队的东西反过来写,详情可以参考题解里普通带修莫队的修改方式做对照。 } } for (int t = nc; t > tim[id[sl]][id[sr]]; --t) if (sl <= change[t].p && change[t].p <= sr) { --CNT[change[t].las]; ++CNT[change[t].col]; } // 临时数组还原 tim[id[sl]][id[sr]] = nc; ima = ans[id[sl]][id[sr]]; while (sl < l) del(sl++, SL, SR); while (sl > l) add(--sl, SL, SR); while (sr < r) add(++sr, SL, SR); while (sr > r) del(sr--, SL, SR); // 可爱的四句莫队 printf("%d\n", ima); while (SL < l) add(SL++, 0, 0); while (SL > l) del(--SL, 0, 0); while (SR < r) del(++SR, 0, 0); while (SR > r) add(SR--, 0, 0); // 临时数组还原 } } }}当然上述代码解决的只是P1903 [国家集训队] 数颜色 / 维护队列原问题,只是我们自己强制自己把这道题写成了在线莫队。
实际上一些问题是强制在线的,不像P1903一样可以转化为离线问题,这时在线莫队就显得尤为重要,可以用相对简单的在线莫队解决相对困难的问题,比如树套树,主席树,Fenwike等等需要高级DS的问题。
具体可以看一下这道题U540166 【模板】诗乃莫队
enum EventType { QUERY, MODIFY };
struct Query { int l, r, t, idx;};
struct Modification { int pos; // 修改位置 int type; // 1: 修改颜色, 2: 修改数字 int prevC; // 若是颜色修改,原来的颜色 int nowC; int prevA; // 若是数字修改,原来的数字 int nowA;};
int n, m, k;int initA[NMAX], curA[NMAX];int initC[NMAX], curC[NMAX]; // curC 存储离散化后的颜色vector<int> compColors;
int totQuery = 0, totMod = 0;vector<Query> queries;vector<Modification> mods;
ll ansArr[NMAX];
// 优化:使用 vector 记录每个颜色(离散化后编号)的当前数字和vector<ll> colSumArr; // 下标范围 [1, totColors]
ll curAns = 0;
// 快速计算 f(x) = x^k,其中 k=1,2,3inline ll f(ll x) { if (k == 1) return x; else if (k == 2) return x * x; else return x * x * x;}
// 内联更新函数:移除位置 pos 的贡献inline void removePos(int pos) { int color = curC[pos]; // 范围 1..totColors int val = curA[pos]; ll oldVal = colSumArr[color]; ll newVal = oldVal - val; curAns -= (f(oldVal) - f(newVal)); colSumArr[color] = newVal;}
// 内联更新函数:添加位置 pos 的贡献inline void addPos(int pos) { int color = curC[pos]; int val = curA[pos]; ll oldVal = colSumArr[color]; ll newVal = oldVal + val; curAns += (f(newVal) - f(oldVal)); colSumArr[color] = newVal;}
// 应用修改操作 modIdx(如果 pos 在当前区间内,先 remove 后 add)void applyModification(int modIdx, int L, int R) { Modification &mod = mods[modIdx]; int pos = mod.pos; if (L <= pos && pos <= R) removePos(pos); if (mod.type == 1) { // 颜色修改:curC[pos] 从 prevC 变为 nowC curC[pos] = mod.nowC; } else { curA[pos] = mod.nowA; } if (L <= pos && pos <= R) addPos(pos);}
// 撤销修改操作 modIdxvoid undoModification(int modIdx, int L, int R) { Modification &mod = mods[modIdx]; int pos = mod.pos; if (L <= pos && pos <= R) removePos(pos); if (mod.type == 1) { curC[pos] = mod.prevC; } else { curA[pos] = mod.prevA; } if (L <= pos && pos <= R) addPos(pos);}
void solve() { cin >> n >> m >> k; for (int i = 1; i <= n; i++) { cin >> initA[i]; curA[i] = initA[i]; } for (int i = 1; i <= n; i++) { cin >> initC[i]; compColors.push_back(initC[i]); curC[i] = initC[i]; // 后续会进行离散化 }
ll lastans = 0; for (int i = 0; i < m; i++) { char op; cin >> op; if (op == 'Q') { int l, r; cin >> l >> r; l ^= lastans; r ^= lastans; if (l > r) swap(l, r); queries.push_back({l, r, (int)totMod, (int)totQuery}); totQuery++; } else if (op == 'C') { int x, y; cin >> x >> y; x ^= lastans; y ^= lastans; compColors.push_back(y); mods.push_back({x, 1, curC[x], y, 0, 0}); curC[x] = y; totMod++; } else { int x, y; cin >> x >> y; x ^= lastans; y ^= lastans; mods.push_back({x, 2, 0, 0, curA[x], y}); curA[x] = y; totMod++; } }
// 离散化:压缩所有颜色 sort(compColors.begin(), compColors.end()); compColors.erase(unique(compColors.begin(), compColors.end()), compColors.end()); int totColors = compColors.size(); auto getColorId = [&](int c) -> int { return (int)(lower_bound(compColors.begin(), compColors.end(), c) - compColors.begin()) + 1; }; for (int i = 1; i <= n; i++) { initC[i] = getColorId(initC[i]); curC[i] = initC[i]; } for (auto &mod : mods) { if (mod.type == 1) { mod.prevC = getColorId(mod.prevC); mod.nowC = getColorId(mod.nowC); } }
for (int i = 1; i <= n; i++) { curA[i] = initA[i]; curC[i] = initC[i]; }
// 初始化 colSumArr,所有颜色贡献初始为 0 colSumArr.assign(totColors + 1, 0); curAns = 0;
int blockSize = max((ll)1, (ll)pow(n, 2.0 / 3.0)); sort(queries.begin(), queries.end(), [&](const Query &A, const Query &B) { int ablock = A.l / blockSize, bblock = B.l / blockSize; if (ablock != bblock) return ablock < bblock; int rblockA = A.r / blockSize, rblockB = B.r / blockSize; if (rblockA != rblockB) return A.r < B.r; return A.t < B.t; });
// 恢复 curA, curC 为初始状态 for (int i = 1; i <= n; i++) { curA[i] = initA[i]; curC[i] = initC[i]; } // colSumArr 已经初始化为 0,curAns = 0 int L = 1, R = 0, curT = 0; for (auto &q : queries) { while (curT < q.t) { applyModification(curT, L, R); curT++; } while (curT > q.t) { curT--; undoModification(curT, L, R); } while (R < q.r) { R++; addPos(R); } while (R > q.r) { removePos(R); R--; } while (L < q.l) { removePos(L); L++; } while (L > q.l) { L--; addPos(L); } ansArr[q.idx] = curAns; lastans = curAns; }
for (int i = 0; i < totQuery; i++) { cout << ansArr[i] << endl; }}二维莫队
莫队二次离线
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!